Étude de cas
Perforce Backup System : remplacer NetBackup sur ~200 instances
Architecte et lead technique du projet : POC, architecture, développement, mise en production, passation
2025 - 2026
Infrastructure distribuée de sauvegarde et de reprise : du POC comparatif Kopia/Restic à la production sur ~200 instances Perforce (~1,3 Po de données sources, ~940 To sauvegardés).
- ~200instances au périmètre global
- ~1,3 Podonnées sources
- ~940 Tosauvegardés
- Restic
- Resticprofile
- Python
- Chef
- systemd
- Azure Blob Storage
- Azure Arc
- HashiCorp Vault
- Prometheus
- Grafana
- Elasticsearch
- Azure Monitor
Le contexte
Environ 200 instances Perforce, allant de 10 Go à 120 To chacune, sauvegardées par une solution commerciale dont le coût mensuel était devenu le premier poste du budget de sauvegarde. La demande était triple : sortir ces sauvegardes de NetBackup, réduire la dépense, et le faire sans dégrader les temps de restauration (dans l’idéal, en les améliorant) ni perdre les fonctionnalités déjà en place (snapshots).
J’ai été sollicité pour concevoir la solution en raison de l’expertise accumulée sur Azure Blob Storage et les systèmes de sauvegarde lors du projet db-backup. Ce détail compte pour la suite : le projet n’est pas parti d’une page blanche, il a capitalisé sur ce qui avait déjà été appris.
La décision : un POC, et surtout le bon critère
Deux outils open source répondaient au besoin sans développement à partir de zéro : Restic et Kopia. Les deux savent faire des snapshots, chiffrer, dédupliquer et écrire dans Azure Blob Storage. Sur le papier, Kopia est même le plus riche des deux : compression multiple, interface graphique, politiques de rétention natives, hooks intégrés, déduplication inter-hôtes.
Le POC a donc été mené sur des données réelles de production, pas sur un jeu de test.
Ce qu’on mesure vraiment dans un POC de sauvegarde
Le critère décisif pour ce parc était le temps de restauration, mesuré sur les données et les scénarios du POC.
Mesurer la fenêtre de sauvegarde est nécessaire, mais ne suffit pas : le backup tourne hors des heures de travail, tandis qu’une restauration lente retarde directement la reprise après incident.
Dans nos scénarios, cet écart pesait davantage dans la décision que quelques heures gagnées sur la sauvegarde nocturne.
Les mesures sur trois scénarios du POC :
- Restauration complète du plus gros dépôt du parc : Restic ≈ 13 h, Kopia > 26 h. Un facteur deux, dans le scénario de reprise après sinistre
- Restauration d’un seul gros fichier (85 Go) : Restic en moins de 3 minutes, Kopia plusieurs heures. L’écart n’est plus un facteur, c’est un changement de nature
- Restauration d’un lot de petits fichiers : Restic plus rapide et surtout plus prévisible
Sur la sauvegarde, le résultat était plus nuancé : Kopia pouvait égaler voire dépasser Restic sur de très gros volumes avec un parallélisme élevé. En restauration, certains essais Kopia ont atteint 126 Go de mémoire. Au-delà d’un certain niveau, augmenter encore le parallélisme dégradait les performances mesurées.
Sur ces mêmes essais, porter azure.connections à 120 donnait à Restic un bon débit avec une consommation de ressources acceptable pour le parc. Selon les scénarios de sauvegarde, Restic consommait légèrement plus de CPU et de RAM que Kopia ; cela n’a pas été limitant ici.
Le paradoxe de la richesse fonctionnelle
Kopia offre davantage de réglages. Sur environ 200 instances, chaque variation de configuration supplémentaire aurait accru le travail de standardisation et le risque de divergence entre serveurs.
Restic offrait moins de leviers à maintenir ; pour ce parc, cela facilitait la configuration et l’exploitation homogènes.
Au moment du POC, Kopia ne prenait pas en charge le RBAC Azure nécessaire au modèle d’authentification visé. J’ai ouvert une pull request sur Kopia pour ajouter la prise en charge d’Azure AD (Managed Identity, Service Principal, jeton Azure CLI) ; elle était encore en cours de revue lors de l’arbitrage et ne pouvait donc pas entrer dans le calendrier du projet. L’historique d’utilisation de Restic constituait aussi un facteur de réduction du risque pour ce service.
La recommandation formelle en faveur de Restic a été présentée aux responsables IT et Sécurité, et validée par la direction.
Comment ça marche
Chaque instance planifie et exécute ses propres sauvegardes avec un timer systemd et Restic. Aucun orchestrateur central unique ne déclenche les jobs de tout le parc : sa panne ne peut donc pas, à elle seule, interrompre leur planification.
-
Exécution
- Restic
- Resticprofile
- systemd timers
-
Configuration & authentification
- Chef
- Azure Arc Managed Identity
- HashiCorp Vault
-
Stockage
- Azure Blob Storage
- un dépôt chiffré AES-256 par instance
-
Observabilité
- Prometheus
- Grafana
- Elasticsearch
- Filebeat
- Azure Monitor
Chaque instance Perforce possède son dépôt Restic chiffré dans son propre conteneur Azure. Ce cloisonnement limite les conséquences d’une corruption ou d’une compromission à ce dépôt, sans éliminer les risques communs au stockage ou aux identités. Pour l’accès, Azure Arc Managed Identity permet de s’authentifier auprès de Vault sans identifiant Azure persistant sur les serveurs ; Chef génère les timers systemd à partir de la configuration déclarée.
Ce mécanisme mérite d’être détaillé, parce qu’il conditionne le passage à l’échelle sur 200 instances. Une seule recette Chef pilote tout le parc : elle installe les binaires Restic et Resticprofile dont les versions sont fixées, puis lit, pour chaque instance, un databag qui déclare ses paramètres propres (chemins à sauvegarder, fenêtre de planification, ressources) et les fusionne avec les valeurs par défaut définies par la recette Chef. La recette en déduit la configuration Resticprofile et les unités systemd de l’instance. Ajouter une instance ou changer sa fenêtre de sauvegarde devient une modification de databag, pas une intervention manuelle sur un serveur.
La recette converge aussi vers l’état déclaré : elle ne réécrit une unité systemd que si son contenu change, évitant un redémarrage à chaque exécution de Chef. À chaque passage, elle compare les instances déclarées à celles présentes sur la machine et désactive les jobs orphelins des instances décommissionnées.
Méthode d’ingénierie assistée par IA
J’ai défini l’architecture initiale, les contraintes et les spécifications d’implémentation, puis utilisé Claude Code (avec des modèles Anthropic via l’API interne de l’entreprise) à la fois pour confronter certains choix techniques et comme coding agent pour l’implémentation, les modifications de code, les tests, le débogage et la documentation. J’ai assuré des revues de code ciblées, défini les critères d’acceptation et validé le comportement obtenu avant de décider du déploiement ; j’ai conservé la responsabilité de la mise en production et de l’exploitation.
Ce que j’ai construit
Quatre composants répondent aux besoins d’observabilité, de validation, d’identité et de configuration du parc : trois outils Python sur mesure et un profil Resticprofile généré.
Exporteur Prometheus
Écrit atomiquement les métriques de chaque opération et instance ; relit le compteur d'échecs consécutifs depuis son fichier précédent pour rendre l'état des sauvegardes observable sans service d'état supplémentaire.
Validateur de configuration
Vérifie chaque heure que les chemins déclarés existent, ne sont ni des liens symboliques ignorés par Restic ni des répertoires vides, et que les timers systemd sont actifs : une configuration valide doit aussi correspondre au disque réel.
Intégration Vault / Azure Arc
Utilise le JWT Azure Arc pour accéder à Vault, valide les entrées avant les sous-processus et masque URLs et jetons dans les journaux d'audit.
Profil Resticprofile
Chef génère depuis les paramètres de chaque instance un profil commun pour la sauvegarde, la rétention, la vérification et la maintenance, sans configurer chaque serveur à la main.
Le compteur d’échecs consécutifs tient compte des cadences différentes : certaines instances sont sauvegardées chaque jour, d’autres trois fois par semaine. Une règle « pas de sauvegarde depuis 24 h » peut alerter à tort sur ces dernières et réagir trop tard sur les premières. Compter les échecs successifs permet d’alerter sur les exécutions manquées sans imposer la même fenêtre de temps à tout le parc.
Le script d’intégration Vault mérite un mot à part, car c’est le seul des trois qui manipule une donnée sensible. Le mot de passe transite uniquement sur stdout, jamais dans un fichier ni un log ; toute entrée (identifiants Azure, chemins Vault) est validée contre l’injection de commande avant d’atteindre un sous-processus ; et la vérification SSL ne peut pas être désactivée en environnement de production, même via un flag explicite.
L’observabilité comprend également 4 tableaux de bord Grafana, 19 règles d’alerte Prometheus appuyées sur des recording rules, et des alertes Azure Monitor de sévérité maximale reliées à ServiceNow pour les événements de sécurité.
Résultats
Le service a été mis en production puis stabilisé sur l’ensemble du parc, réduisant le coût mensuel de la sauvegarde Perforce d’environ 87 % : soit un ordre de grandeur d’un million de dollars par an.
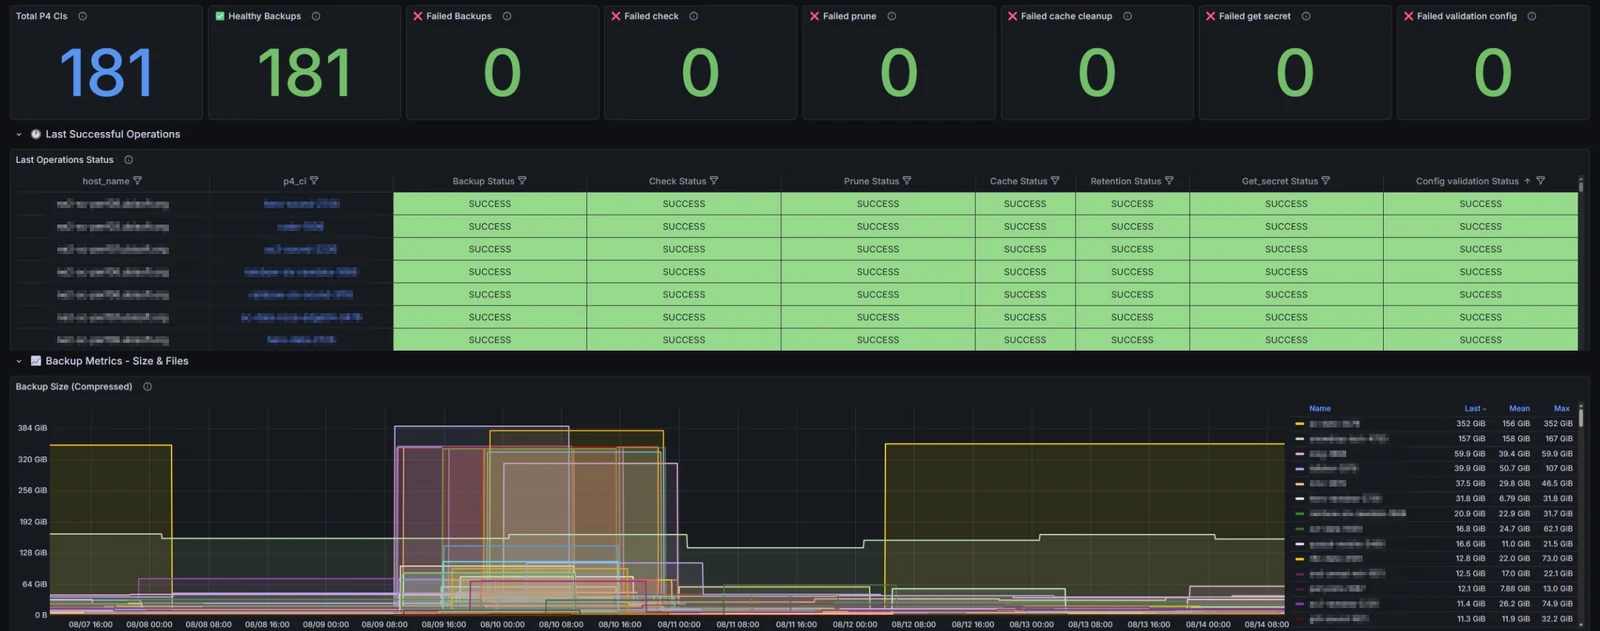
Le projet s’est conclu par une passation à l’équipe Ops : documentation technique et d’architecture, procédures d’exploitation, runbook par alerte, guide de restauration illustré, et cours vidéo couvrant la maintenance et le diagnostic d’incidents.
Ce que j’en retiens
Le critère de décision compte plus que le nombre de fonctionnalités. Dans notre POC, mesurer la restauration sur les scénarios critiques a conduit à choisir Restic malgré les options supplémentaires de Kopia. Ce résultat répondait à notre charge et à nos contraintes, pas à toutes les comparaisons possibles entre ces outils.
La standardisation est un choix d’exploitation. Sur ce parc, moins de variations de configuration réduisaient le travail nécessaire pour maintenir des instances cohérentes.
Un arbitrage technique se défend devant des non-spécialistes. Présenter le résultat aux responsables IT et Sécurité a demandé de traduire des benchmarks en risque et en coût. C’est cette traduction, pas les mesures elles-mêmes, qui a emporté la décision.