Étude de cas
Perforce Backup Replication : ~940 To sur quatre régions Azure
Conception et développement, à la demande du Security Risk Management
2026
Infrastructure de reprise interrégionale : copies indépendantes de ~940 To de sauvegardes Restic sur deux paires de régions Azure, avec synchronisation mensuelle des changements depuis le cycle précédent.
- ~940 Tode sauvegardes couvertes par la réplication
- 4régions Azure
- 41tests automatisés
- Python 3.13
- Azure Functions
- Durable Functions
- AzCopy
- Terraform
- Azure Blob Storage
- Managed Identity
- OIDC / WIF
- GitLab CI/CD
- pytest
- Azurite
Le contexte
Le Security Risk Management demandait une copie des sauvegardes Perforce dans une autre région Azure et une souscription dédiée, sans sortir du périmètre géographique prévu pour les données. Une copie limitée au compte et à la région d’origine ne répondait pas à ces scénarios de perte de région ou de compromission de ce compte.
Pour ce volume d’environ 940 To et environ 35 To de changements à synchroniser chaque mois, le chiffrage comparait le GRS, service géré de réplication géographique, au LRS existant complété par une copie indépendante. Le premier représentait environ 15 000 $/mois de surcoût estimé ; le pipeline retenu, environ 2 200 $/mois. Le GRS aurait réduit le système à maintenir, mais ne fournissait pas le même cloisonnement par souscription que la copie visée.
La décision : une copie indépendante plutôt que GRS
L’application Azure Functions synchronise, pour chaque périmètre, un compte source vers un compte de destination dans une autre région et une souscription dédiée. Le pipeline contrôle la fréquence mensuelle et le choix des niveaux de stockage Cool/Archive.
L’écart de coût estimé justifiait ici d’assumer davantage de code, de tests, d’observabilité, d’exploitation et de reprise. Ce choix répond à ce périmètre et à cette fréquence de réplication ; le GRS aurait évité une partie de cette charge opérationnelle.
Pourquoi Durable Functions, et pas une Function ordinaire
Un cycle de transfert peut durer plusieurs jours, plus longtemps que l’exécution d’un worker. Découper le travail ne suffit pas si la progression est perdue lors d’un redémarrage.
Durable Functions persiste l’état de l’orchestration pendant que les activités de transfert s’exécutent séparément : le worker peut être recyclé sans reprendre tout le cycle depuis le début.
Les checkpoints par shard précisent ensuite quelle part d’un transfert interrompu doit être relancée.
Comment ça marche
Le pipeline se déclenche une fois par mois et synchronise les changements depuis le cycle précédent. Les conteneurs ne sont pas traités de la même manière selon leur taille : un conteneur de quelques gigaoctets se copie d’un bloc, un conteneur de plusieurs dizaines de téraoctets doit être découpé.
Le déploiement comprend deux paires source-destination indépendantes : une paire de régions EMEA couvrant les instances EMEA et APAC, et une paire de régions NCSA dédiée aux instances NCSA. La réplication reste ainsi dans le périmètre géographique de stockage associé à chaque groupe.
-
Déclenchement : timer mensuel, le premier lundi
-
Classification automatique des quelque 190 conteneurs de sauvegarde concernés par la réplication : actif, décommissionné, ou candidat au sharding selon son volume
-
Traitement en fan-out, avec un maximum de 96 processus AzCopy simultanés :
- petits conteneurs : copie directe, un job chacun
- gros conteneurs (plus de 25 000 blobs) : répartis en un maximum de 256 sous-jobs (
data/00àdata/ff), chacun confié à un sous-orchestrateur dédié
-
Checkpoint individuel par shard : un worker qui redémarre reprend à son dernier point, pas au début
-
Arrivée sur le compte B, dans l’autre région, au niveau Cool ou Archive selon l’état du dépôt et les règles de cycle de vie.
Trois détails de conception distinguent ici un simple script de copie d’un système conçu pour limiter le nombre de transferts simultanés et reprendre après interruption sans recopier les shards déjà terminés.
Limitation de la concurrence. Lancer simultanément tous les conteneurs chargerait le réseau et les workers sans contrôle. La limite de 96 processus AzCopy simultanés permet de maintenir un débit élevé : lorsqu’un transfert se termine, un nouveau peut démarrer, sans dépasser cette limite.
Le sharding par préfixe. Restic range les blobs de données sous data/00 à data/ff. Le pipeline réutilise ces 256 préfixes comme frontières de parallélisation, sans définir un nouveau schéma de partitionnement ; les autres chemins du dépôt restent à prendre en charge dans la copie.
Le checkpoint granulaire. Si la reprise se faisait seulement par conteneur, un incident à 90 % d’un conteneur de 40 To obligerait à recommencer ce conteneur. Les checkpoints par shard permettent de conserver les shards terminés et de reprendre ceux qui restent ; les préfixes ne contiennent pas nécessairement chacun 1/256 des données.
La gestion des niveaux de stockage de destination suit trois règles : les dépôts Perforce actifs sont répliqués en Cool, les dépôts décommissionnés en Archive ; lors de la première synchronisation, si les fichiers snapshot source ont plus de 30 jours, la destination utilise directement le niveau Archive, sinon le niveau Cool ; Azure Lifecycle Management déplace ensuite automatiquement vers Archive tout fichier vieux de plus de 180 jours.
Le problème des verrous
La gestion des verrous constitue un autre cas de reprise à traiter explicitement. Restic pose un verrou sur son dépôt pendant certaines opérations de maintenance, notamment le prune. Copier un dépôt pendant une opération de maintenance risquerait de produire une copie incohérente.
La solution retenue consiste à différer la copie : quand un conteneur est verrouillé, il n’est pas considéré comme un échec ; il est remis en file et réessayé, jusqu’à 72 heures. Cela laisse le temps à un prune long de se terminer avant de relancer la copie du conteneur dans un état cohérent.
Le système ne cherche donc pas à contourner le verrou : il attend que l’opération de maintenance se termine, puis reprend automatiquement.
Méthode d’ingénierie assistée par IA
J’ai défini l’architecture initiale, les contraintes et les spécifications d’implémentation, puis utilisé Claude Code (avec des modèles Anthropic via l’API interne de l’entreprise) à la fois pour confronter certains choix techniques et comme coding agent pour l’implémentation, les modifications de code, les tests, le débogage et la documentation. J’ai assuré des revues de code ciblées, défini les critères d’acceptation et validé le comportement obtenu avant de décider du déploiement ; j’ai conservé la responsabilité de la mise en production et de l’exploitation.
Ce que j’ai construit
L’application est écrite en Python 3.13 sur Azure Functions Flex Consumption, avec Durable Functions pour l’orchestration et AzCopy comme moteur de transfert.
Le pipeline n’utilise pas de secret applicatif persistant pour s’authentifier à Azure : le runtime utilise Managed Identity et la CI/CD utilise OIDC avec fédération d’identité de charge de travail. Il n’émet pas de jeton SAS pour les transferts ; un Network Security Perimeter restreint l’accès réseau aux ressources Azure concernées.
Ces identités évitent de stocker, distribuer et renouveler des identifiants Azure statiques pour ce pipeline. Elles ne signifient pas qu’aucun secret n’existe ailleurs dans l’écosystème.
L’infrastructure est décrite en Terraform sur plusieurs environnements, déployée par un pipeline GitLab CI/CD à déclenchement manuel contrôlé. Le déploiement reste volontairement déclenché manuellement plutôt qu’automatiquement à chaque merge, compte tenu du volume de sauvegardes concerné (~940 To).
La validation repose sur une suite de 41 tests automatisés, comprenant des tests unitaires exécutables sans Azure et des tests d’intégration avec Azurite, dont six scénarios de sharding et six scénarios de chaos. Ces derniers simulent l’interruption d’un worker et vérifient la reprise attendue dans ces scénarios ; ils ne prouvent pas la résistance à toute panne en production.
La reprise
Un processus GitLab CI/CD prépare la restauration d’une instance depuis le stockage répliqué : réhydratation Archive si nécessaire, transfert du dépôt vers un compte de stockage dédié, puis restauration de l’instance Perforce avec Restic.
Résultats
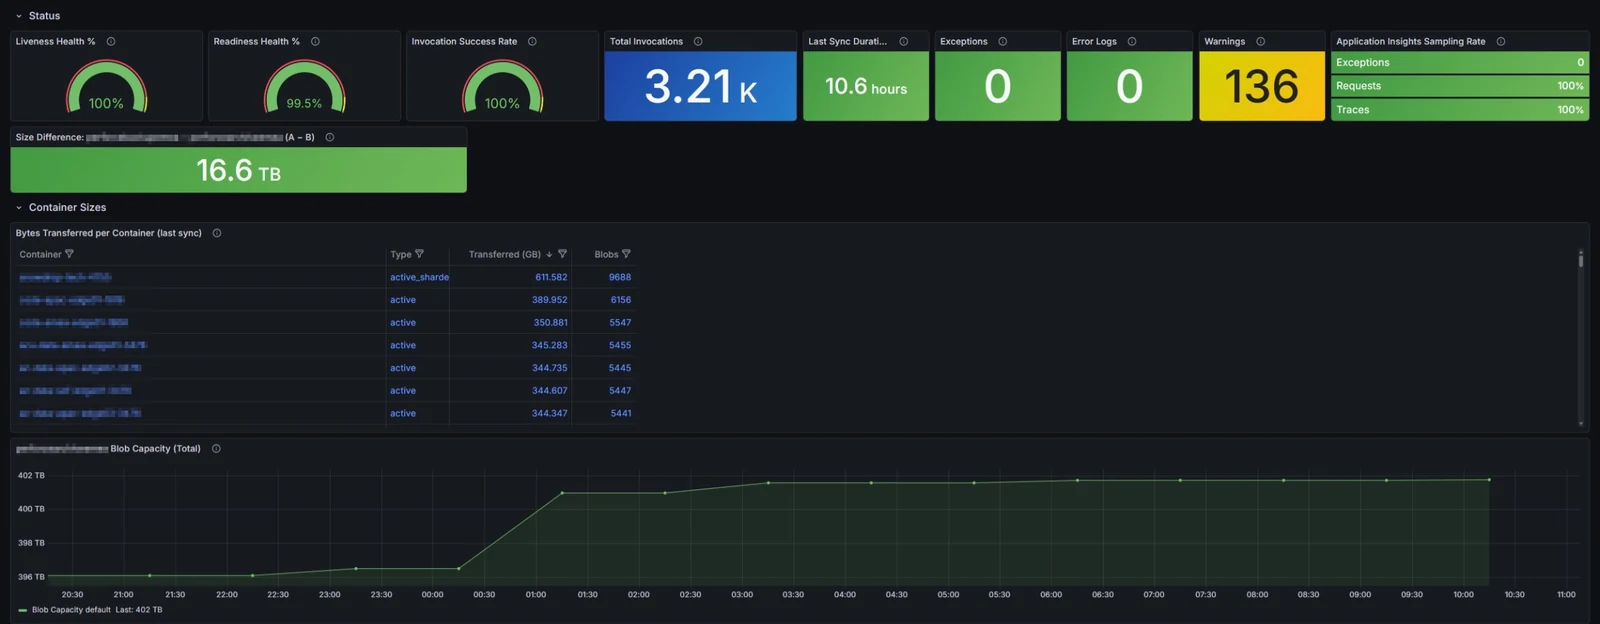
Le pipeline maintient une copie indépendante d’environ 940 To de sauvegardes Perforce sur quatre régions Azure, organisées en deux paires source-destination pour les périmètres EMEA/APAC et NCSA. Chaque cycle mensuel synchronise les changements depuis le cycle précédent, avec un contrôle explicite du niveau de stockage et du processus de reprise.
Ce que j’en retiens
Ce projet pose une question d’exploitation concrète : que reprend-on lorsqu’un transfert long s’interrompt ?
Un worker peut être recyclé et un dépôt verrouillé pendant un cycle. Les checkpoints par shard conservent le travail terminé ; les dépôts verrouillés attendent leur prochain passage dans la fenêtre prévue, sans forcer la copie.
Le choix face au GRS se justifiait ici par le coût estimé et le besoin de copie indépendante, avec une contrepartie explicite : construire et opérer notre propre processus de réplication et de reprise.